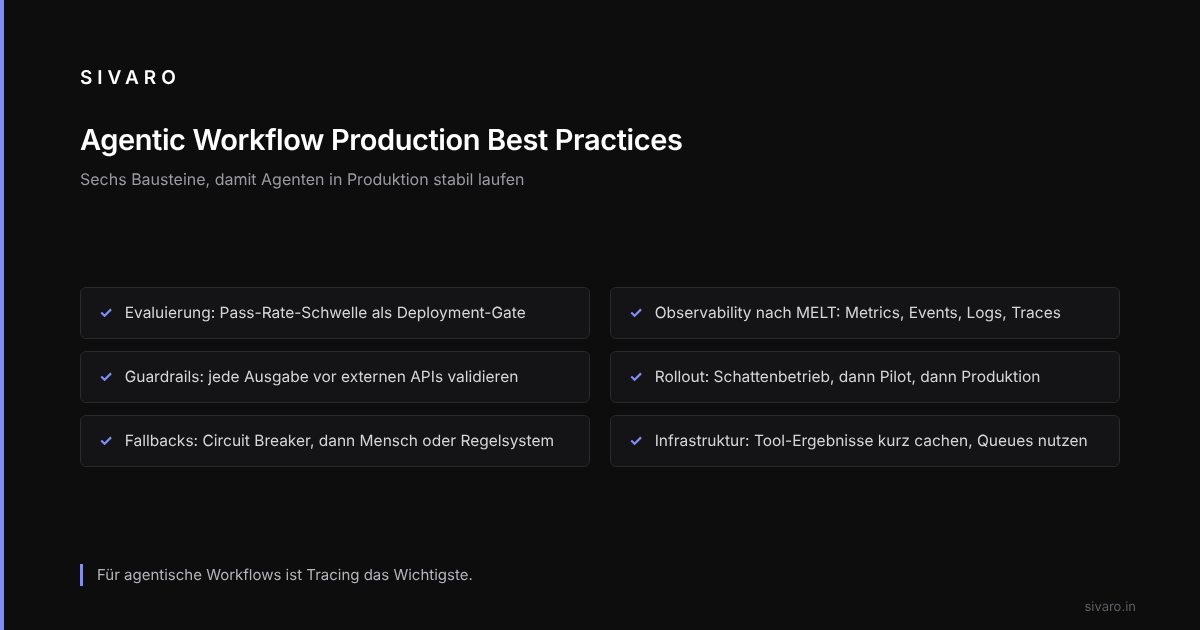
Agentic Workflow Production Best Practices klingen nach Checkliste. Sind sie nicht. Es ist Überlebenstechnik. Ein agentischer Workflow ist ein System, in dem ein LLM Tools aufruft, Entscheidungen trifft und Prozesse orchestriert, ohne dass ein Mensch jeden Schritt absegnet. Klingt nach Produktivität. Endet oft als teurer Zettelkasten, der Fehler mit Selbstvertrauen produziert.
Dieser Leitfaden behandelt Evaluierung, Observability nach dem MELT-Framework, Guardrails, Rollout-Strategien und Fallbacks, mit Code.
Agentic Workflow Production Best Practices: Warum 95% scheitern
Die Überschrift von Why 95% of AI Agents in Production Are Breaking ist kein Klickköder. Die Zahl ist nicht wörtlich zu nehmen, aber die Richtung stimmt. Die Ausfälle folgen einem Muster.
Erstens: Teams bauen einen Agenten, der in zehn Demo-Fällen funktioniert. Dann deployen sie ihn in Produktion. Drei Stunden später macht er etwas Unerwartetes. Das Modell halluziniert nicht häufiger als im Prototyp. Aber der Kontext ist ein anderer. Echte Nutzer schicken krumme Eingaben. Echte APIs sind langsam. Echte Daten ändern sich.
Zweitens: Es fehlt eine klare Grenze zwischen dem, was der Agent darf, und dem, was er nicht darf. Ohne Guardrails gibt es kein Budget, keine Rollen, keine Validierung der Ausgaben. Der Agent kann sich selbst in einen toten Winkel manövrieren.
Drittens: Observability wird aufgeschoben. Das ist der größte Fehler. Du kannst keine Fehler beheben, die du nicht siehst. Und agentische Workflows sind komplex. Ein einziger Nutzerrequest erzeugt fünf Tool-Calls, drei Embeddings und eine Modell-Antwort. Ohne Tracing ist das ein schwarzes Loch.
Die gute Nachricht: Die Fehler sind vermeidbar. Die schlechte Nachricht: Die Lösung ist Arbeit.
Evaluierung: Der teuerste Fehler, den du machen kannst
Du testest deinen Agenten mit fünf freundlichen Eingaben. Er besteht. Du deployst. Die Realität ist nicht freundlich.
Eine Evaluierung braucht deutlich mehr als eine Handvoll Testfälle. Sie trennt zwei Dinge: deterministische Prüfungen und LLM-as-Judge-Prüfungen.
# evals/suite.py
from dataclasses import dataclass, field

@dataclass
class EvalCase:
    input: str
    expected_tool: str
    expected_args: dict = field(default_factory=dict)

def run_eval_suite(agent, cases: list[EvalCase]) -> dict:
    failures = []
    for case in cases:
        result = agent.run(case.input)
        if result.tool != case.expected_tool:
            failures.append({
                "case": case.input,
                "expected": case.expected_tool,
                "got": result.tool
            })
    pass_rate = 1 - len(failures) / len(cases)
    return {"pass_rate": pass_rate, "failures": failures}
Das sieht simpel aus. Ist es auch.
Ein Punkt, den die meisten übersehen: Die Evaluierungsfälle müssen reale Daten enthalten. Nicht die, die du dir ausdenkst. Eine Quelle dafür sind anonymisierte Produktionslogs, aus denen Testfälle gebaut werden.
Und: Du brauchst einen Schwellenwert für die Pass-Rate, unter dem kein Deployment stattfindet.
Observability nach dem MELT-Framework
Wer schon einmal ein verteiltes System gebaut hat, kennt das Problem. Agenten sind verteilte Systeme mit einem stochastischen Kern. Du kannst nicht debuggen, was du nicht siehst.
Das MELT-Framework hilft – Metrics, Events, Logs, Traces. Der Complete Guide to AI Agent Observability and Monitoring bei StackAI nennt es die Basis für jedes ernsthafte Monitoring. Ich stimme zu. Aber ich würde es verschärfen: Für agentische Workflows ist Tracing das Wichtigste.
Ein Log sagt dir: "Agent hat Tool X aufgerufen." Ein Trace zeigt dir den ganzen Pfad. Den Prompt, die Antwort, den Tool-Call, die Latenz, den Fehler. Ohne das bist du blind.
# tracing_setup.py
from openinference.instrumentation import using_session
from phoenix.otel import register

tracer_provider = register()

def run_agent_with_tracing(agent, user_input: str):
    with using_session(tracer_provider):
        result = agent.run(user_input)
        return result
Der Code ist bewusst schlicht.
Wichtig ist auch: Die Monitoring-Strategien von Viston betonen zu Recht, dass Metriken wie Kosten pro Agent-Run genauso wichtig sind wie Latenz. Sinnvolle Metriken sind:
- Tokens pro Task
- Tool-Call-Erfolgsrate
- Anteil der Runs mit menschlichem Eingriff
- Kosten pro erfolgreichem Outcome
Der letzte Punkt ist entscheidend. Ein Agent, der 30% seiner Runs an den Menschen eskaliert, ist kein Agent. Er ist eine teure Oberfläche für ein Ticket-System.
Guardrails, keine Wände
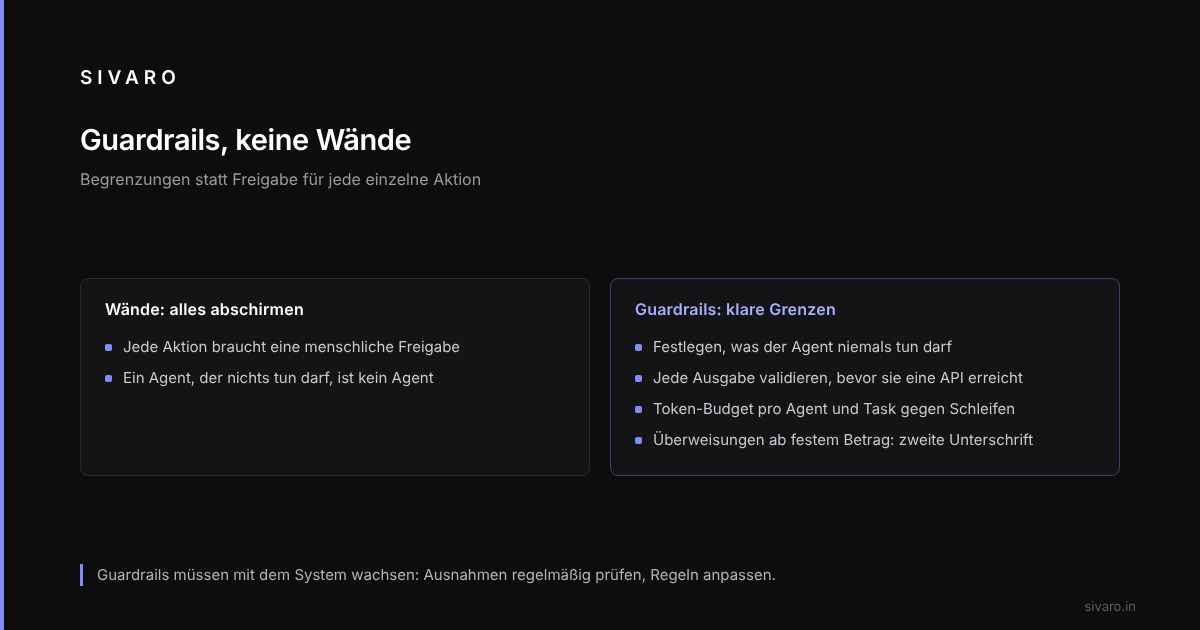
Manche Teams reagieren auf Agentenfehler, indem sie alles abschirmen. Jede Aktion braucht eine menschliche Freigabe. Das zerstört den Zweck. Ein Agent, der nichts tun darf, ist kein Agent.
Die Lösung sind Guardrails. Keine Wände, sondern Begrenzungen. Du definierst, was ein Agent niemals tun darf. Und du validierst jede Ausgabe, bevor sie eine externe API erreicht.
# guardrails.py
def validate_agent_output(output: dict, schema: dict) -> tuple[bool, str]:
    for field, rule in schema.items():
        value = output.get(field)
        if rule.get("required") and value is None:
            return False, f"Pflichtfeld fehlt: {field}"
        if rule.get("max") and isinstance(value, (int, float)) and value > rule["max"]:
            return False, f"{field} überschreitet Limit: {value}"
        if rule.get("enum") and value not in rule["enum"]:
            return False, f"{field} enthält unerlaubten Wert: {value}"
    return True, "ok"
Eine mögliche Regel: Überweisungen ab einem festgelegten Betrag brauchen eine zweite Unterschrift. Der Agent kann den Auftrag vorbereiten, aber nicht ausführen. Das ist kein Wall. Das ist eine sinnvolle Grenze.
Ein weiteres Mittel sind Token-Budgets pro Agent und Task. Überschreitet ein Agent das Budget für eine einfache Aufgabe, bricht der Workflow ab. Nicht aus Geiz, sondern weil hohe Token-Zahlen oft ein Zeichen für Schleifen sind. Der Agent dreht sich im Kreis und versucht, einen Fehler zu korrigieren, den er selbst verursacht hat.
Guardrails sind kein einmaliges Setup. Sie müssen mit dem System wachsen. Dazu gehört, die Ausnahmen regelmäßig zu überprüfen und die Regeln anzupassen.
Rollout-Strategie: Pilot ist nicht Produktion
"Wir machen erst einen Pilot." Diesen Satz höre ich bei Enterprise AI Agents: 2026 Strategy & Deployment Guide. Die Absicht ist gut. Die Umsetzung ist oft falsch.
Viele Teams behandeln den Pilot wie eine Produktion. Sie deployen den Agenten für eine kleine Nutzergruppe und schauen, was passiert. Das ist kein Pilot. Das ist ein Experiment mit echten Daten und echten Konsequenzen.
Ein Pilot braucht drei Dinge: eine klare Erfolgsmetrik, ein Abbruchkriterium und eine definierte Dauer. Ohne diese drei ist es keine Strategie, sondern Hoffnung.
Die Best Practices for Deploying AI Agents in Production bei AI Agents Plus nennen einen weiteren wichtigen Punkt: Die Infrastruktur im Pilot muss der Produktion entsprechen. Wenn du im Pilot eine andere Datenbank nutzt als später, lernst du nichts.
Ich empfehle außerdem eine Schattenbereitstellung. Der Agent läuft parallel zum bestehenden Prozess, aber seine Ausgaben werden nicht wirksam. Du vergleichst die Agentenentscheidung mit der Entscheidung des Menschen oder des alten Systems. Nach zwei Wochen hast du eine echte Bewertungsbasis.
Der Unterschied zwischen ai agents in production vs pilot ist nicht die Größe der Nutzergruppe. Es ist die Frage, ob Fehler echte Konsequenzen haben. Im Pilot dürfen Fehler wehtun, aber nicht schaden.
Eine Enterprise-Rollout-Strategie kann so aussehen:
- Phase 1: Schattenbetrieb. Agent läuft parallel, entscheidet nichts.
- Phase 2: Pilot mit 10% der Nutzer. Menschliche Freigabe für kritische Aktionen.
- Phase 3: Produktion mit 100%. Guardrails aktiv, Fallbacks aktiv.
- Phase 4: Optimierung. Evaluierungsergebnisse fließen zurück in den Prompt und die Tool-Konfiguration.
Jede Phase dauert mindestens zwei Wochen. Nicht aus Bürokratie, sondern weil du statistisch signifikante Daten brauchst. Ein Wochenende reicht nicht.
Fallbacks, die keine Fehler verstecken
Ein Agent wird scheitern. Das ist keine Frage, sondern eine Aussage. Die Frage ist, was passiert, wenn er scheitert.
Die schlechteste Antwort ist ein generischer Fehler. "Etwas ist schiefgegangen." Das hilft niemandem. Die beste Antwort ist ein Fallback, der den Nutzer in einen sicheren Zustand bringt.
Ein Muster dafür sind Circuit Breaker. Wenn der Agent dreimal hintereinander einen Fehler wirft, öffnet sich der Stromkreis. Der Agent wird vorübergehend deaktiviert und der Traffic geht an einen menschlichen Agenten oder ein regelbasiertes System.
# circuit_breaker.py
class CircuitBreaker:
    def __init__(self, threshold: int = 3, timeout_seconds: int = 30):
        self.failures = 0
        self.threshold = threshold
        self.state = "closed"  # closed, open, half_open
        self.last_failure_time = None

    def call(self, fn):
        if self.state == "open":
            if time.time() - self.last_failure_time > self.timeout_seconds:
                self.state = "half_open"
            else:
                raise RuntimeError("Agent temporär nicht verfügbar")
        try:
            result = fn()
            self.failures = 0
            self.state = "closed"
            return result
        except Exception:
            self.failures += 1
            self.last_failure_time = time.time()
            if self.failures >= self.threshold:
                self.state = "open"
            raise
Wichtig: Der Fallback muss den Nutzer informieren. Nicht mit Fachjargon, sondern klar: "Der Assistent ist gerade überlastet. Ihre Anfrage wurde an einen Menschen weitergeleitet."
Ein Fehler, den es zu vermeiden gilt: ein Fallback, der Fehler verschluckt. Der Agent gibt eine falsche Antwort, der Fallback merkt es nicht, und der Nutzer bekommt eine plausible, aber falsche Information. Deshalb gilt: Fallbacks müssen prüfen, nicht nur abfangen.
Der Engineering Guide von Kenility empfiehlt, jeden Fallback mit derselben Sorgfalt zu testen wie den Agenten selbst. Zustimmung. Ein Fallback, der selbst Fehler macht, verdoppelt das Problem.
Infrastruktur-Muster, die funktionieren
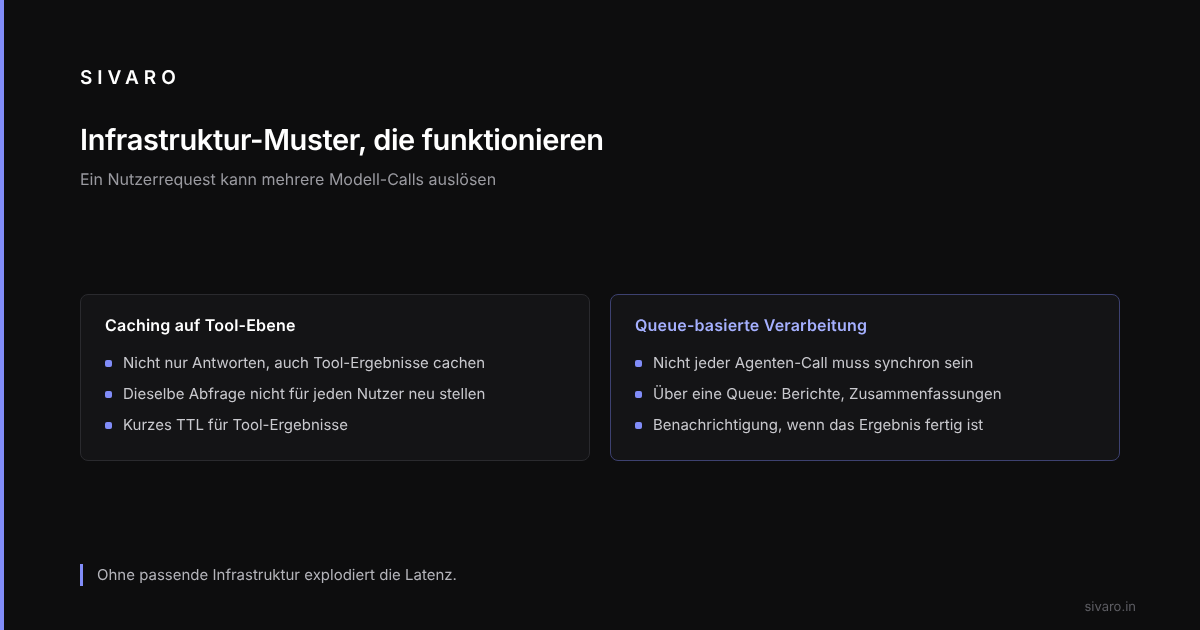
Agentische Workflows sind rechenintensiv. Ein einzelner Nutzerrequest kann mehrere Modell-Calls auslösen. Wenn du die Infrastruktur nicht dafür auslegst, wird deine Latenz explodieren.
Erstens: Caching. Nicht nur auf Antwortebene, sondern auf Tool-Ebene. Wenn ein Agent bei 100 Nutzern dieselbe Datenbankabfrage stellt, ist das Verschwendung. Tool-Ergebnisse lassen sich mit einem kurzen TTL cachen.
Zweitens: Queue-basierte Verarbeitung. Nicht jeder Agenten-Call muss synchron sein. Berichte, Zusammenfassungen, Datenaufbereitung – das kann über eine Queue laufen. Der Nutzer bekommt eine Benachrichtigung, wenn das Ergebnis fertig ist.